去識別化是什麼?步驟、範例與匿名化、假名化差異
去識別化(de-identification)是把個人資料處理成難以或無法識別特定個人的過程,假名化與匿名化都是去識別化的做法:假名化以代碼取代姓名等識別資訊,持有對照表的人仍能還原;匿名化則讓任何人以合理方式都無法再識別個人。兩者在法律上的效果差很多。
想把客戶或員工資料拿去做分析、訓練 AI 模型或交給合作夥伴的企業,常以為「把姓名拿掉」就不算個資了。以下說明三個名詞的差異、可照做的五個步驟、一個實際範例,以及台灣個資法與 GDPR 怎麼看;需要協助判斷資料能不能這樣用,可參考個資法顧問服務。
一句話結論:資料只在公司內部分析、未來可能要回頭找人時,用假名化並嚴格保管對照表;要公開或交給外部且不需要還原時,才追求匿名化,並先評估再識別風險。
去識別化、假名化、匿名化的定義
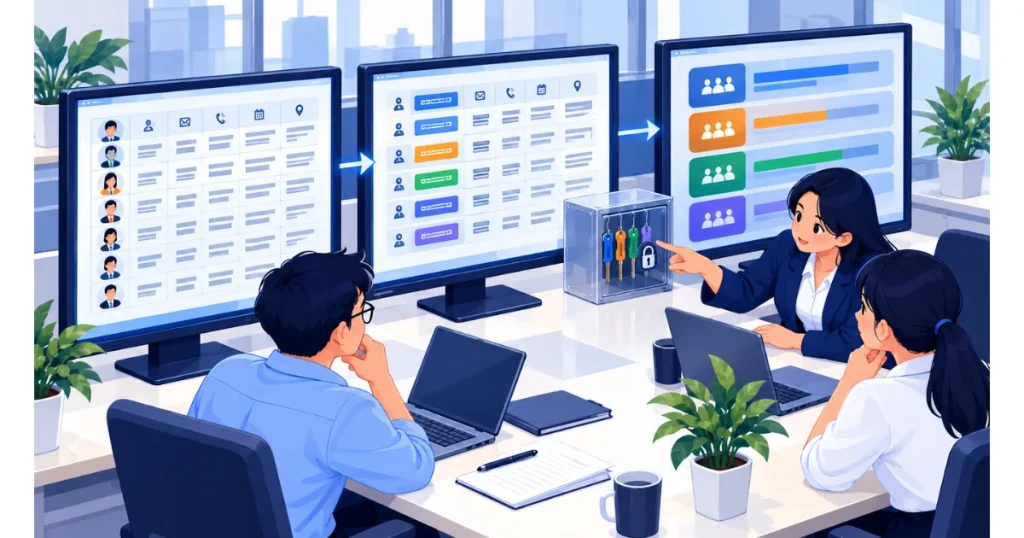
去識別化是總稱,指降低或消除資料與特定個人連結的處理;國際標準 ISO/IEC 20889:2018 就是整理去識別化術語與技術分類的標準。假名化與匿名化,則是依「能不能還原」區分的兩種結果。
假名化是以代碼、權杖等取代可直接識別的資訊,還原所需的對照資料分開保存。GDPR 第 4 條第 5 款的定義即強調:須將還原所需的額外資訊分開保存,並加以技術與組織保護。匿名化則是處理到考量所有合理可能使用的方法後,仍無法識別個人;GDPR 前言第 26 點明言,匿名資料不適用資料保護原則。
台灣個資法沒有使用「假名化」「匿名化」兩個詞,而是以「無從識別特定當事人」表示。個資法施行細則第 17 條規定,這是指個人資料「以代碼、匿名、隱藏部分資料或其他方式,無從辨識該特定個人者」。
匿名化與假名化差異比較
兩者最關鍵的差別是還原的可能性,這也決定了資料是否仍受個資法規範。
| 比較項目 | 假名化 | 匿名化 |
|---|---|---|
| 做法 | 以代碼、權杖、加鹽雜湊取代識別資訊 | 刪除識別資訊並降低精確度、彙整或加入雜訊 |
| 能否還原 | 持有對照表者可還原 | 以合理方式無法還原 |
| 是否仍為個資 | 對持有對照表的企業而言仍是 | 真正匿名者不再是個資 |
| 資料可用性 | 高,可做個人層級追蹤分析 | 較低,適合統計與趨勢 |
| 主要風險 | 對照表外洩、與其他資料串接 | 處理不足時被重新識別 |
| 適合情境 | 內部分析、委外處理、研究追蹤 | 開放資料、對外發布、跨組織分享 |
歐盟的見解也在演進。歐盟法院 2025 年 9 月 4 日在 EDPS 訴 SRB 案(C-413/23 P)判決,假名化資料對無法重新識別的接收方而言,未必屬於個人資料;但對持有對照表的原控制者,仍是個資。
去識別化步驟:五個階段照著做
去識別化不是按一個按鈕,而是從目的到風險檢視的完整流程。臺北市政府民國 112 年 3 月訂定的〈個資去識別化平臺標準作業流程〉,把處理程序分為五個階段,企業也可直接沿用:
- 釐清資料使用目的,依資料最小化原則只挑選必要欄位。
- 辨識直接識別個資(姓名、身分證字號)、間接識別個資(生日、郵遞區號)與敏感資料。
- 選擇處理方式:直接識別個資加密或刪除,間接識別個資降低精確度。
- 評估去識別化效果,例如以 K-匿名法檢查每種組合至少有 K 筆相同。
- 檢視隱私洩漏風險,例如嘗試以網路搜尋、開放資料或新聞比對出特定人。
同一份作業流程也要求,去識別化的處理人員與檢驗人員不得由同一人兼任。這個「兩人原則」很適合企業照做,因為自己處理的資料,自己最難看出漏洞。
去識別化範例:一筆會員資料怎麼處理
以下用一筆虛構的會員資料示範。假名化保留了分析價值,但只要拿到對照表就能還原;匿名化版本則犧牲了精確度,換取無法識別。
| 欄位 | 原始資料 | 假名化 | 匿名化(一般化) |
|---|---|---|---|
| 姓名 | 王小明 | M-10293 | 刪除 |
| 手機 | 0912-345-678 | 權杖 T8F2Q… | 刪除 |
| 生日 | 1988/05/14 | 1988/05/14 | 1985–1989 年 |
| 地址 | 臺北市大安區○○路 | 臺北市大安區○○路 | 臺北市 |
| 消費金額 | 3,250 元 | 3,250 元 | 3,000–3,499 元 |
假名化版本保留了完整生日與地址,這正是風險所在。美國學者 Latanya Sweeney 在 2000 年估計,郵遞區號、性別與完整生日三項組合,就能唯一識別約 87% 的美國人;後續 Philippe Golle 以 2000 年人口普查重新分析,結果約為 63%。即使比例有爭議,間接識別資料能把人找回來,已是共識。
去識別化在個資法上的意義
在台灣,資料若已「無從識別特定當事人」,部分原本受限的蒐集與利用就有例外,例如個資法第 6 條第 1 項第 4 款、第 16 條第 5 款、第 19 條第 1 項第 4 款與第 20 條第 1 項第 5 款。但要注意,這些例外的主體多半是公務機關或學術研究機構,目的限於統計或學術研究。
換句話說,一般企業拿會員資料做行銷分析或訓練 AI,不能只因為做了去識別化,就當作免除告知與目的限制的理由。實務上一般認為,企業若仍保有對照表,資料對它而言仍屬個資,仍應依原蒐集目的使用,並納入個資盤點清冊與安全維護措施。
健保資料庫的憲法爭議也提醒企業:111 年憲判字第 13 號判決雖未宣告個資法第 6 條第 1 項但書第 4 款違憲,但指出欠缺獨立監督機制與當事人請求停止利用的規定,要求 3 年內修法。去識別化從來不是單獨就能解決所有問題的工具。
去識別化常見誤區
第一個誤區是「雜湊過就是匿名」。台灣手機號碼為 09 開頭加 8 碼,只有約 1 億種組合,攻擊者把所有號碼算一次雜湊即可比對還原;未加鹽的雜湊只能算假名化。
第二個誤區是只刪姓名。生日、地址、職稱、門市等欄位組合起來,在小公司或小社區很容易對應到特定人。第三個誤區是做完一次就不管:資料持續累積、外部可取得的資料越來越多,去識別化效果也需要定期重新檢視,並寫進個資檔案安全維護計畫。
準備用資料做分析前,先問哪三件事?
先問三個問題:這個分析需要回頭找到個人嗎?資料會不會離開公司?處理後的資料,能不能用網路或其他資料比對出人?三題的答案決定該用假名化還是匿名化,以及要不要先取得當事人同意。
整體個資規範可先參考個資法重點整理;若正在規劃 AI 或資料分析專案,歡迎預約一次免費諮詢,先確認資料能怎麼用。
去識別化常見問題
去識別化後還算個資嗎?
要看能不能還原。假名化資料對持有對照表的企業而言,仍可間接識別個人,依個資法第 2 條仍屬個人資料;真正匿名、以合理方式無法識別任何人的資料,才不再是個資。依個資法施行細則第 17 條,「無從識別」須達到無從辨識該特定個人的程度。
雜湊算匿名化嗎?
通常不算。雜湊是固定演算法,相同輸入產生相同結果,手機號碼、身分證字號這類組合有限的資料,只要把所有可能值算一次就能比對回來。加鹽雜湊並妥善保管鹽值可以降低風險,但在法律上一般仍視為假名化,資料仍受個資法規範。
參考資料
- 個人資料保護法施行細則 – 第 17 條「無從識別特定當事人」之定義。法務部
- 臺北市政府個資去識別化平臺標準作業流程 – 去識別化五階段與處理原則。臺北市政府 · 民國 112 年 3 月 28 日
- ISO/IEC 20889:2018 – 去識別化術語與技術分類。ISO · 2018 年
- GDPR Recital 26 – 假名化資料仍屬個資,匿名資料不受規範。歐盟
- Simple Demographics Often Identify People Uniquely – 郵遞區號、性別、生日的識別力研究。Latanya Sweeney · 2000 年